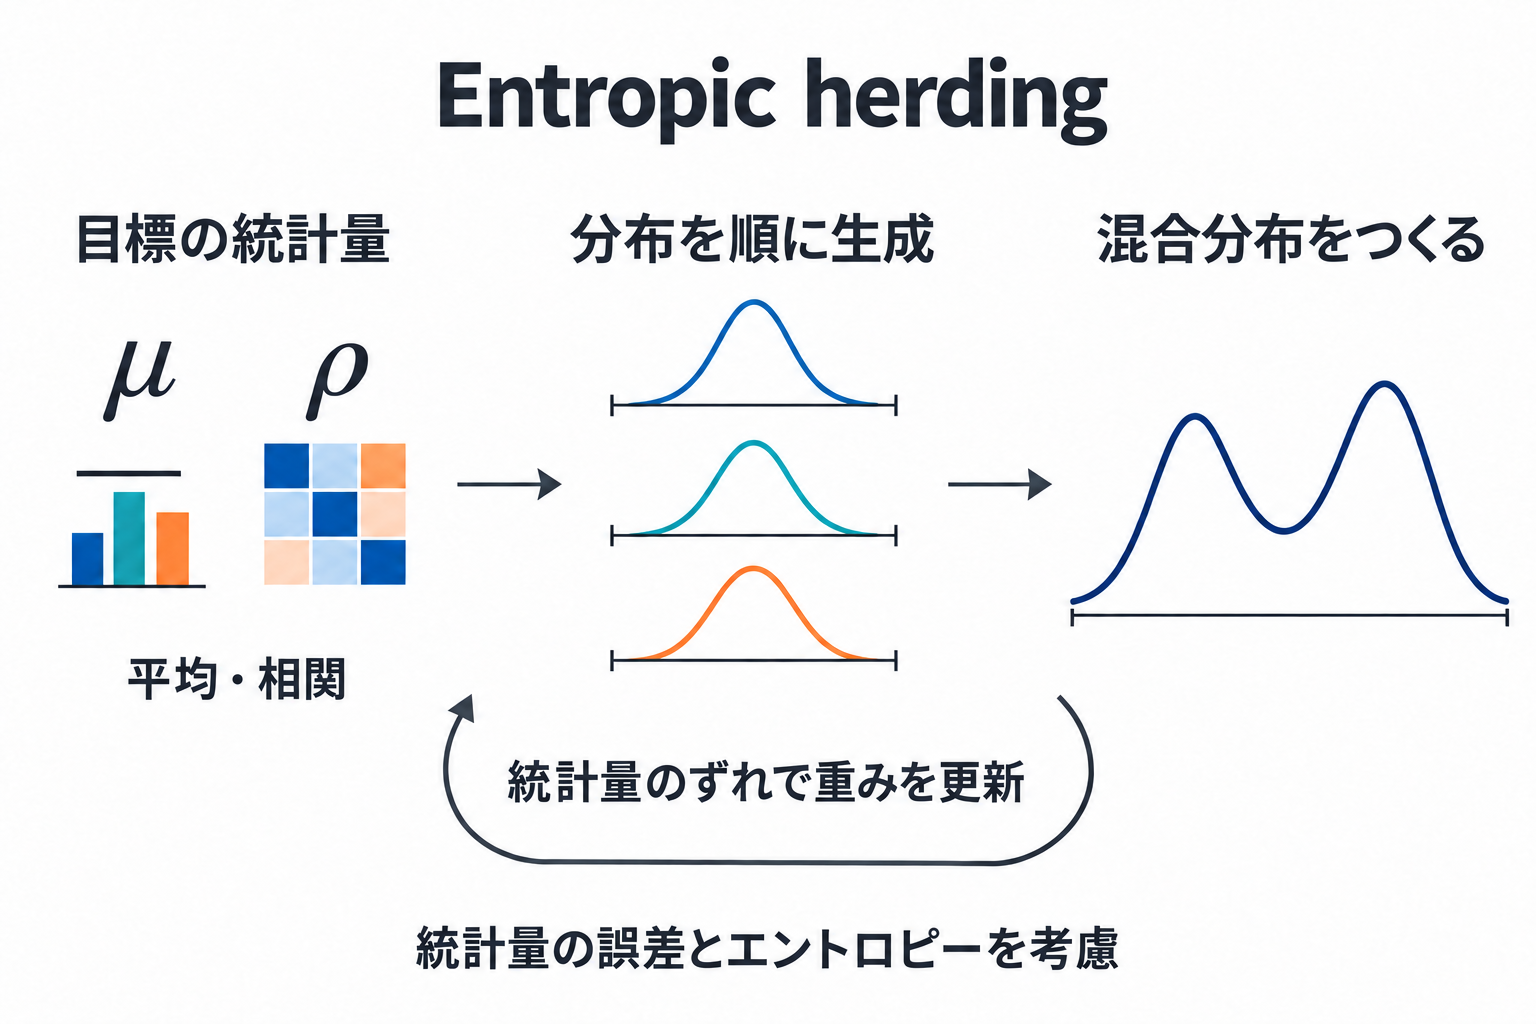
分布を重ねて、統計量から確率モデルをつくる
Hiroshi Yamashita, Hideyuki Suzuki, and Kazuyuki Aihara, “Entropic herding,” Statistics and Computing 33, 31 (2023).
個々の観測値は手元になくても、平均や変数間の相関などの統計量が分かっていることがあります。その情報から、どのような確率分布を構成できるでしょうか。Herding は、指定された統計量に合うように点の列を生成する方法です。この研究で提案する entropic herding は、その一つ一つを、正規分布などの扱いやすい確率分布へ置き換えます。統計量のずれに応じて重みを更新し、次に加える分布を選ぶ操作を繰り返すことで、それらを重ね合わせた混合分布をつくります。各成分が単純でも、その組合せによって複数の山や変数間の依存関係を表せます。
中心的な貢献は、統計量の誤差とエントロピーを組み合わせた目的関数からこの方法を導き、herding と最大エントロピー原理との関係を明確にした点です。与えられた情報に合わせながら、それ以外の偏りをできるだけ加えない、という考え方を、計算可能な形へ緩和しています。目的関数の最適分布を解析するとともに、候補を点分布に限り、更新則を適切に選ぶと従来の herding が得られることを示しました。また、各ステップでのエントロピーの最適化に加え、動的な重みの更新から多様な成分が生まれれば、混合分布のエントロピーが高まる仕組みを考察しています。
出力を明示的な確率モデルとして扱えるため、適切な成分分布を選べば、確率密度の計算、尤度によるモデル評価、構成した混合分布からの独立な標本生成が可能です。数値実験では、人工的な二峰性分布やボルツマンマシンに加え、ワインのデータを用いた分類と欠損値の条件付き分布推定を示しました。実際の出力には有限のペナルティ係数や近似最適化に由来する誤差が残り、一般的な収束保証は与えていません。統計量を合わせる herding を、密度評価や推論にも使える分布の構成法へ広げた研究です。